coverPiccoverPic

广义线性模型笔记

🎈前言

一直都挺好奇广义线性模型(Generalized Linear Model)是怎么跑起来的。以前经常遇到这个东西,不过之前用的时候一直都在当纯粹的调包侠,没有去纠结它的原理。最近又突然想起来这个东西就在空闲时间看了一下…就…虽然和现在的前端工作也没什么关系就是了。

广义线性模型由 Nelder 和 Wed derburn 在 1972 年提出,详见 Generalized Linear Models。简单来说,广义线性模型就是使用连接函数(Link Function),使得可以是非连续、非正态的因变量可以表示为自变量的线性组合。对于线性回归模型,假设变量连续、正态。对于因变量离散、非正态的情况,线性回归模型的假设就得不到满足。而广义线性模型仅要求因变量的分布属于指数分布族(Exponential Family),对因变量没有任何的限制。

这篇博客主要是 Annette J. Dobson 的 《AN INTRODUCTION TO GENERALIZED LINEAR MODELS SECOND EDITION》的学习笔记。

🧵指数分布族

指数分布族是仅依赖一个参数 θ\theta,概率分布形式如下的分布:

f(y;θ)=exp⁡(a(y)b(θ)+c(θ)+d(y))f(y;\theta)=\exp(a(y)b(\theta)+c(\theta)+d(y))

当 a(y)a(y) 是恒等函数时,称为自然形式(Canonical Form):

f(y;θ)=exp⁡(yb(θ)+c(θ)+d(y))f(y;\theta)=\exp(yb(\theta)+c(\theta)+d(y))

不难发现,正态分布、二项分布、泊松分布等很多常见的分布都属于指数分布族:

分布 密度函数 指数分布族的样子
正态 12πσexp⁡(−(y−μ)22σ2)\frac{1}{\sqrt{2 \pi}\sigma}\exp(-\frac{(y-\mu)^2}{2\sigma^2}) exp⁡(μσ2y−μ22σ2−12log⁡(2πσ2)−y22σ2)\exp(\frac{\mu}{\sigma^2}y-\frac{\mu^2}{2\sigma^2}-\frac{1}{2}\log(2\pi\sigma^2)-\frac{y^2}{2\sigma^2})
泊松 λkk!e−λ\frac{\lambda^k}{k!}e^{- \lambda} exp⁡(ylog⁡θ−θ−log⁡y!)\exp(y\log\theta - \theta-\log y!)
分布 质量函数 指数分布族的样子
二项 (nπ)πk(1−π)n−k\tbinom{n}{\pi}\pi^k(1-\pi)^{n-k} exp⁡(ylog⁡π1−π+nlog⁡(1−π)+log⁡(ny))\exp(y \log \frac{\pi}{1-\pi}+n\log(1-\pi)+\log\tbinom{n}{y})

假设 YY 服从指数分布族,

∫−∞+∞f(y;θ)dy=1\int^{+\infin}_{-\infin} f(y;\theta) \text{d}y = 1

如果 ff 和 ∂f∂θ\frac{\partial f}{\partial \theta} 在 (−∞,+∞)×[m,n](-\infin,+\infin) \times[m,n] 一致连续,

ddθ∫f(y;θ)dy=∫∂∂θf(y;θ)dy=0∫f(y;θ)(a(y)b′(θ)+c′(θ))dy=0\frac{\text{d}}{\text{d} \theta}\int f(y;\theta) \text{d}y = \int \frac{\partial}{\partial \theta}f(y;\theta) \text{d}y = 0\\ \int f(y;\theta)(a(y)b^{\prime}(\theta)+c^{\prime}(\theta)) \text{d}y = 0

于是就有

∫f(y;θ)a(y)dy=E(a(Y))=−c′(θ)b′(θ)(1)\begin{aligned} \int f(y;\theta)a(y) \text{d}y = \text{E}(a(Y)) = -\frac{c^{\prime}(\theta)}{b^{\prime}(\theta)} &&(1) \end{aligned}

接下来求方差 Var(a(Y))\text{Var}(a(Y)),如果 ∂2f∂θ2\frac{\partial^2 f}{\partial \theta^2} 存在,类似地,

∂2∂θ2f(y;θ)=((a(y)b′′(θ))+c′′(θ))f(y;θ)+(a(y)b′(θ)+c′(θ))2f(y;θ)\frac{\partial^2}{\partial \theta^2}f(y;\theta)=((a(y)b^{\prime\prime}(\theta))+c^{\prime\prime}(\theta))f(y;\theta)+(a(y)b^{\prime}(\theta)+c^{\prime}(\theta))^2f(y;\theta)

由(1),右侧第二项可以写成

(b′(θ))2⋅(a(y)−E(a(Y)))2f(y;θ)(b^{\prime}(\theta))^2\cdot (a(y)-\text{E}(a(Y)))^2f(y;\theta)

由于 ∫(a(y)−E(a(Y)))2f(y;θ)dy=Var(a(Y))\int(a(y)-\text{E}(a(Y)))^2f(y;\theta)\text{d} y=\text{Var}(a(Y)),∫f(y;θ)dy=1\int f(y;\theta) \text{d}y = 1

∫∂2∂θ2f(y;θ)dy=b′′(θ)E(a(Y))+c′′(θ)+(b′(θ))2Var(a(Y))=0\int\frac{\partial^2}{\partial \theta^2}f(y;\theta)\text{d}y=b^{\prime\prime}(\theta)\text{E}(a(Y))+c^{\prime\prime}(\theta)+(b^{\prime}(\theta))^2\text{Var}(a(Y))=0

于是,

Var(a(Y))=b′′(θ)c′(θ)−c′′(θ)b′(θ)(b′(θ))3(2)\begin{aligned} \text{Var}(a(Y))=\frac{b^{\prime\prime}(\theta)c^{\prime}(\theta)-c^{\prime\prime}(\theta)b^{\prime}(\theta)}{(b^{\prime}(\theta))^3}&&(2) \end{aligned}

🧶广义线性模型

广义线性模型要求因变量 Y1,Y2,⋯YNY_1,Y_2,\cdots Y_N 是独立随机变量,服从同一个自然形式的指数分布族的分布,它们的参数 θi\theta_i 不一定相同。模型假设 g(E(Yi))g(\text{E}(Y_i)) 可以由 pp(p<Np<N)个自变量 xijx_{ij} 的线性组合表示,gg 是连接函数:

E(Yi)=μig(μi)=xiTβxiT=(xi1,xi2,⋯ ,xip)β=(β1,β,⋯ ,βp)T\text{E}(Y_i)=\mu_i\\ g(\mu_i)=x_i^T\beta\\ x^T_i=(x_{i1},x_{i2},\cdots,x_{ip})\\ \beta=(\beta_1,\beta_,\cdots,\beta_p)^T

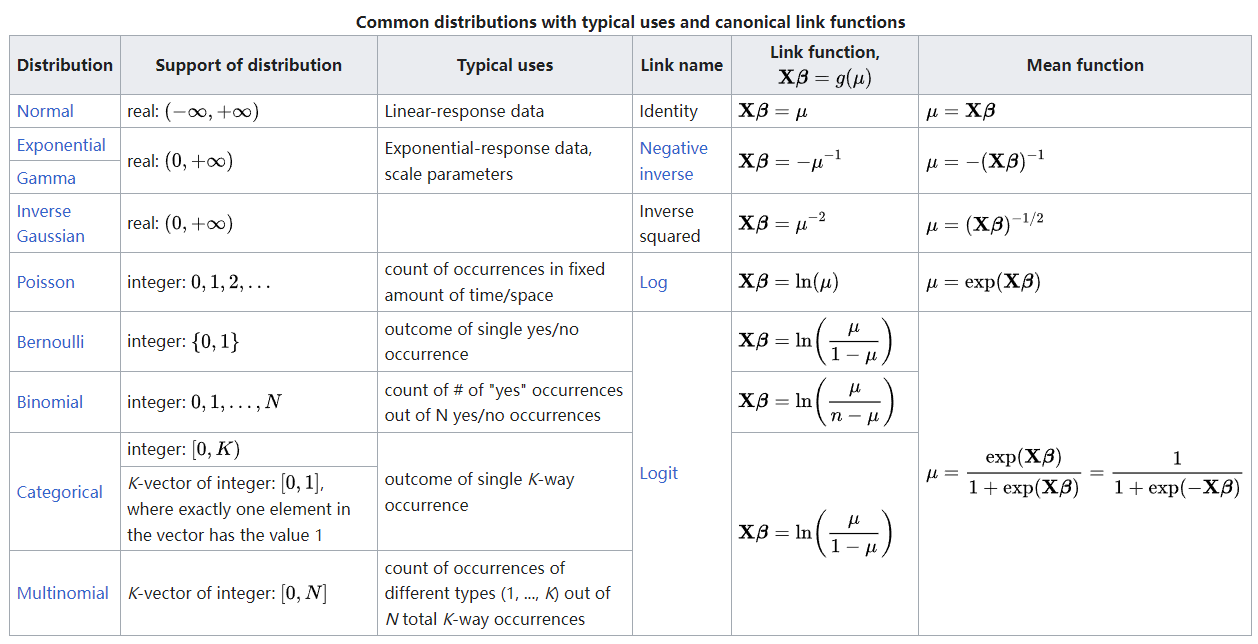
关于连接函数的选择,似乎一下子没有搜到什么资料,下面是维基百科的一个常见连接函数表格:

🔮最大似然估计

参数求解使用最大似然估计进行,对于每个 YiY_i 有对数似然函数:

li=yib(θi)+c(θ)+d(yi)l_i=y_ib(\theta_i)+c(\theta)+d(y_i)

加起来就是

l=∑i=1Nli=∑yib(θi)+∑c(θ)+∑d(yi)l=\sum^N_{i=1}l_i=\sum y_ib(\theta_i)+\sum c(\theta) + \sum d(y_i)

由于难以获得解析解,这里使用牛顿法进行数值求解,迭代过程用 bkb_k 表示 β\beta。

bk+1=bk−(∇2l)−1∇lb_{k+1}=b_k-(\nabla^2l)^{-1}\nabla l

∇lj=Uj=∂∂βj(∑yib(θi)+∑c(θ)+∑d(yi))=∑i=1N∂li∂θi∂θi∂μi∂μi∂βj\begin{aligned} \nabla l&_j=U_j=\frac{\partial}{\partial \beta_j}(\sum y_ib(\theta_i)+\sum c(\theta) + \sum d(y_i))\\ &=\sum_{i=1}^{N} \frac{\partial l_i}{\partial \theta_i}\frac{\partial \theta_i}{\partial \mu_i}\frac{\partial \mu_i}{\partial \beta_j} \end{aligned}\\

根据(1):

∂li∂θi=yib′(θi)+c′(θi)=b′(θi)(yi−μi)\frac{\partial l_i}{\partial \theta_i}=y_ib^{\prime}(\theta_i)+c^{\prime}(\theta_i)=b^{\prime}(\theta_i)(y_i-\mu_i)

再根据(1)和(2):

∂θi∂μi=1/∂μi∂θi∂μi∂θi=b′′(θi)c′(θi)−c′′(θi)b′(θi)(b′(θi))2=b′(θi)Var(Yi)\frac{\partial \theta_i}{\partial \mu_i}=1/\frac{\partial \mu_i}{\partial \theta_i}\\ \frac{\partial \mu_i}{\partial \theta_i}=\frac{b^{\prime\prime}(\theta_i)c^{\prime}(\theta_i)-c^{\prime\prime}(\theta_i)b^{\prime}(\theta_i)}{(b^{\prime}(\theta_i))^2}=b^{\prime}(\theta_i)\text{Var}(Y_i)

由 g(μi)=xiTβg(\mu_i)=x_i^T\beta

∂μi∂βj=∂μi∂g(μi)∂g(μi)∂βj=∂μi∂g(μi)xij\frac{\partial \mu_i}{\partial \beta_j}=\frac{\partial \mu_i}{\partial g(\mu_i)}\frac{\partial g(\mu_i)}{\partial \beta_j}=\frac{\partial \mu_i}{\partial g(\mu_i)}x_{ij}

因此

Uj=∑i=1Nyi−μiVar(Yi)xij∂μi∂g(μi)U_j=\sum ^N_{i=1} \frac{y_i-\mu_i}{Var(Y_i)}x_{ij}\frac{\partial \mu_i}{\partial g(\mu_i)}

记黑塞矩阵 J=∇2lJ=\nabla^2l,一般我们都取它的期望值 E(J)\text{E}(J),这里不直接计算 JJ,我们使用费舍尔信息矩阵(Fiesh Infomation Matric),它是一阶梯度协方差矩阵的期望,可以证明它是黑塞矩阵期望的负值,见这里。

−Jjk=E(UjUk)=E(∑i=1Nyi−μiVar(Yi)xij∂μi∂g(μi)⋅∑l=1Nyl−μlVar(Yl)xlk∂μl∂g(μl))\begin{aligned} -J_{jk} &= \text{E}(U_jU_k)\\ &=E(\sum ^N_{i=1} \frac{y_i-\mu_i}{Var(Y_i)}x_{ij}\frac{\partial \mu_i}{\partial g(\mu_i)} \cdot \sum ^N_{l=1} \frac{y_l-\mu_l}{Var(Y_l)}x_{lk}\frac{\partial \mu_l}{\partial g(\mu_l)})\\ \end{aligned}

由 YiY_i 相互独立,E((Yi−μi)(Yl−μl))=0\text{E}((Y_i-\mu_i)(Y_l-\mu_l))=0,i≠li \not= l

−Jjk=∑i=1NE((Yi−μi)2)xijxik(Var(Yi))2(∂μi∂g(μi))2=∑i=1NVar(Yi)xijxik(Var(Yi))2(∂μi∂g(μi))2=∑i=1NxijxikVar(Yi)(∂μi∂g(μi))2\begin{aligned} -J_{jk}&=\sum^{N}_{i=1}\frac{\text{E}((Y_i-\mu_i)^2)x_{ij}x_{ik}}{(\text{Var}(Y_i))^2}(\frac{\partial \mu_i}{\partial g(\mu_i)})^2\\ &=\sum^{N}_{i=1}\frac{\text{Var}(Y_i)x_{ij}x_{ik}}{(\text{Var}(Y_i))^2}(\frac{\partial \mu_i}{\partial g(\mu_i)})^2\\ &=\sum^{N}_{i=1}\frac{x_{ij}x_{ik}}{\text{Var}(Y_i)}(\frac{\partial \mu_i}{\partial g(\mu_i)})^2 \end{aligned}

因此

bk+1=bk+(E(J))−1Ub_{k+1}=b_k+(\text{E}(J))^{-1}U

🔍模型检验

模型检验一般考虑对数似然(比)统计量(Log Likelihood (Ratio) Statistic)。用 DD,即 Deviance 表示。

D=2(l(bmax;y)−l(b;y))D=2(l(b_{max};y)-l(b;y))

ll 是对数似然函数。bmaxb_{max} 是全模型的估计的参数,全模型的参数数量在各个模型中是最多的。bb 是你所感兴趣的模型的参数估计。DD 服从非中心的卡方分布,

D∼X(m−p,v)D\sim \Chi(m-p,v)

mm、pp 分别是全模型、所感兴趣的模型的参数数量,v=2(l(bmax;y)−l(b;y))v=2(l(b_{max};y)-l(b;y)) 如果所感兴趣的模型拟合得全模型差不多好,vv 接近于 0。

对于相同连接函数和分布的两个广义线性模型,

H0:β=β0=(β1,⋯ ,βq)H1:β=β1=(β1,⋯ ,βp)q<pH_0:\beta=\beta_0=(\beta_1,\cdots,\beta_q)\\ H_1:\beta=\beta_1=(\beta_1,\cdots,\beta_p)\\ q<p

考虑统计量

ΔD=D0−D1=2(l(b1;y)−l(b0;y))\Delta D=D_0-D_1=2(l(b_1;y)-l(b_0;y))

如果两个模型拟合效果相近,有 ΔD∼X(p−q)\Delta D\sim \Chi(p-q),当 ΔD\Delta D 大于 X(p−q)\Chi(p-q) 的 α\alpha%,拒绝零假设。

?结语

这篇博客稍微简单地回顾了一下广义线性模型的计算方法和模型验证。

0 条评论未登录用户
Ctrl or + Enter 评论
© 2023-2025 LittleRangiferTarandus, All rights reserved.
🌸 Run